Tecnologia e algoritmos
Por que Instagram, Spotify, Netflix e TikTok parecem conhecer você tão bem?
Entenda como algoritmos de recomendação usam sinais de comportamento, ranking, embeddings e machine learning para decidir o que aparece no seu feed, nas suas músicas e nos seus filmes.
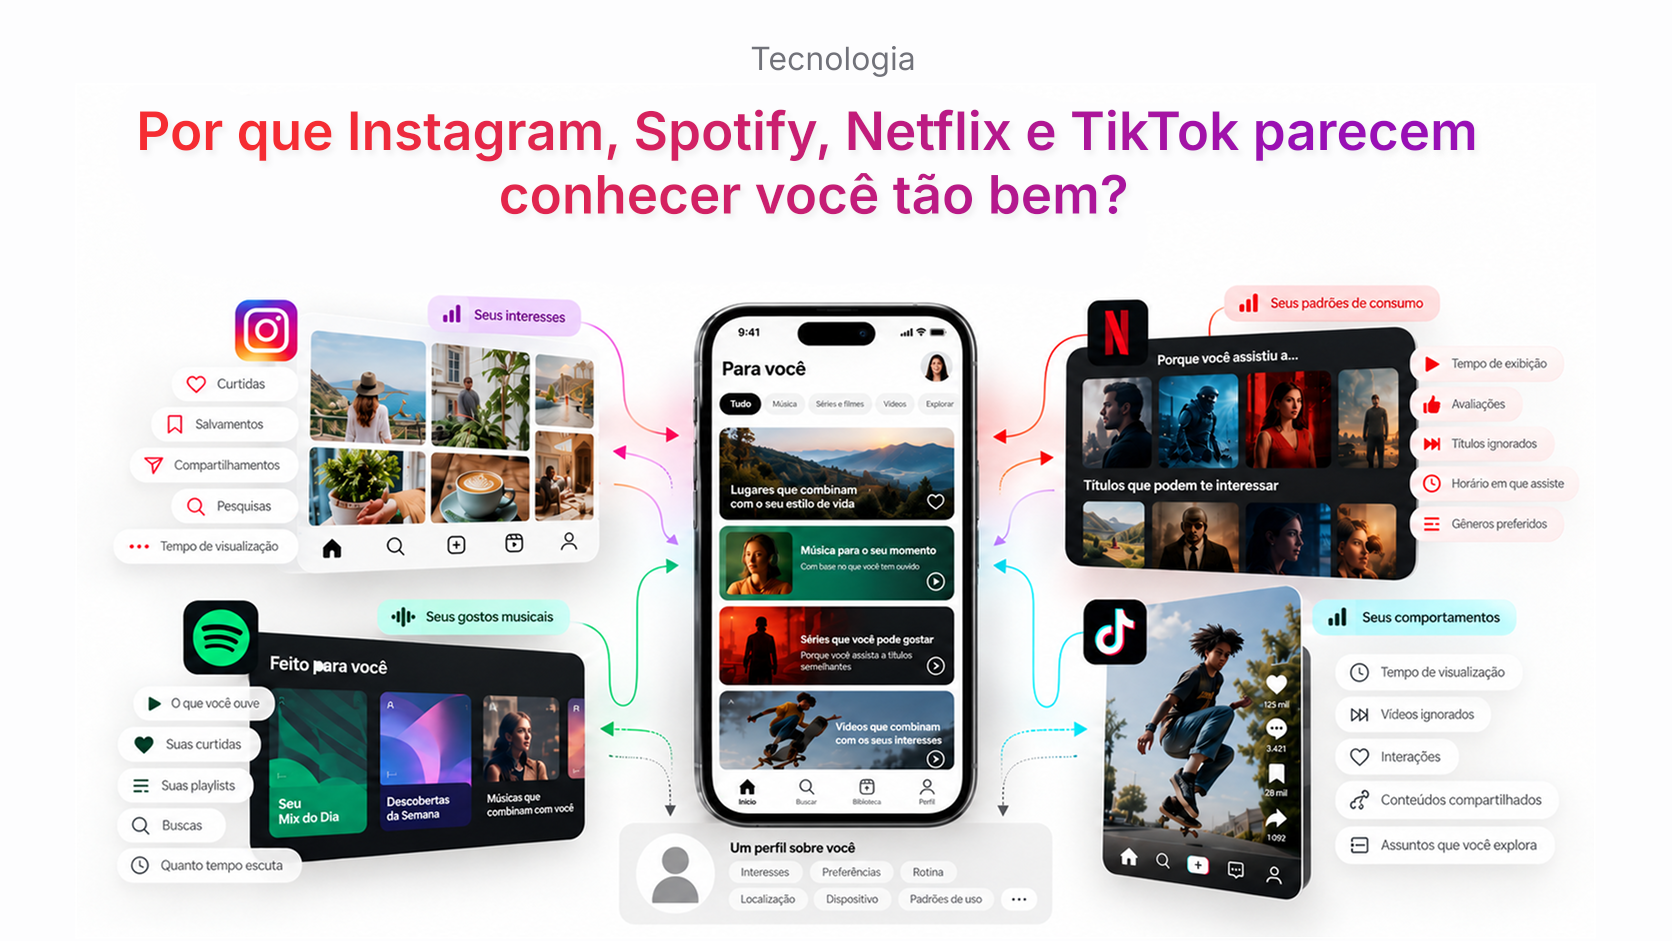
Você abre o Instagram e aparece exatamente o tipo de vídeo que costuma prender sua atenção.
Entra no Spotify e a próxima música parece ter sido escolhida para o seu momento.
Abre a Netflix e a primeira fileira já está cheia de filmes e séries que combinam com aquilo que você costuma assistir.
No TikTok, basta alguns minutos rolando a tela para o feed parecer completamente diferente do de outra pessoa.
Às vezes a sensação é quase desconfortável:
Como eles sabem que eu gosto disso?
A resposta costuma ser menos misteriosa — e tecnicamente mais interessante — do que parece.
Essas plataformas não precisam “ler sua mente”.
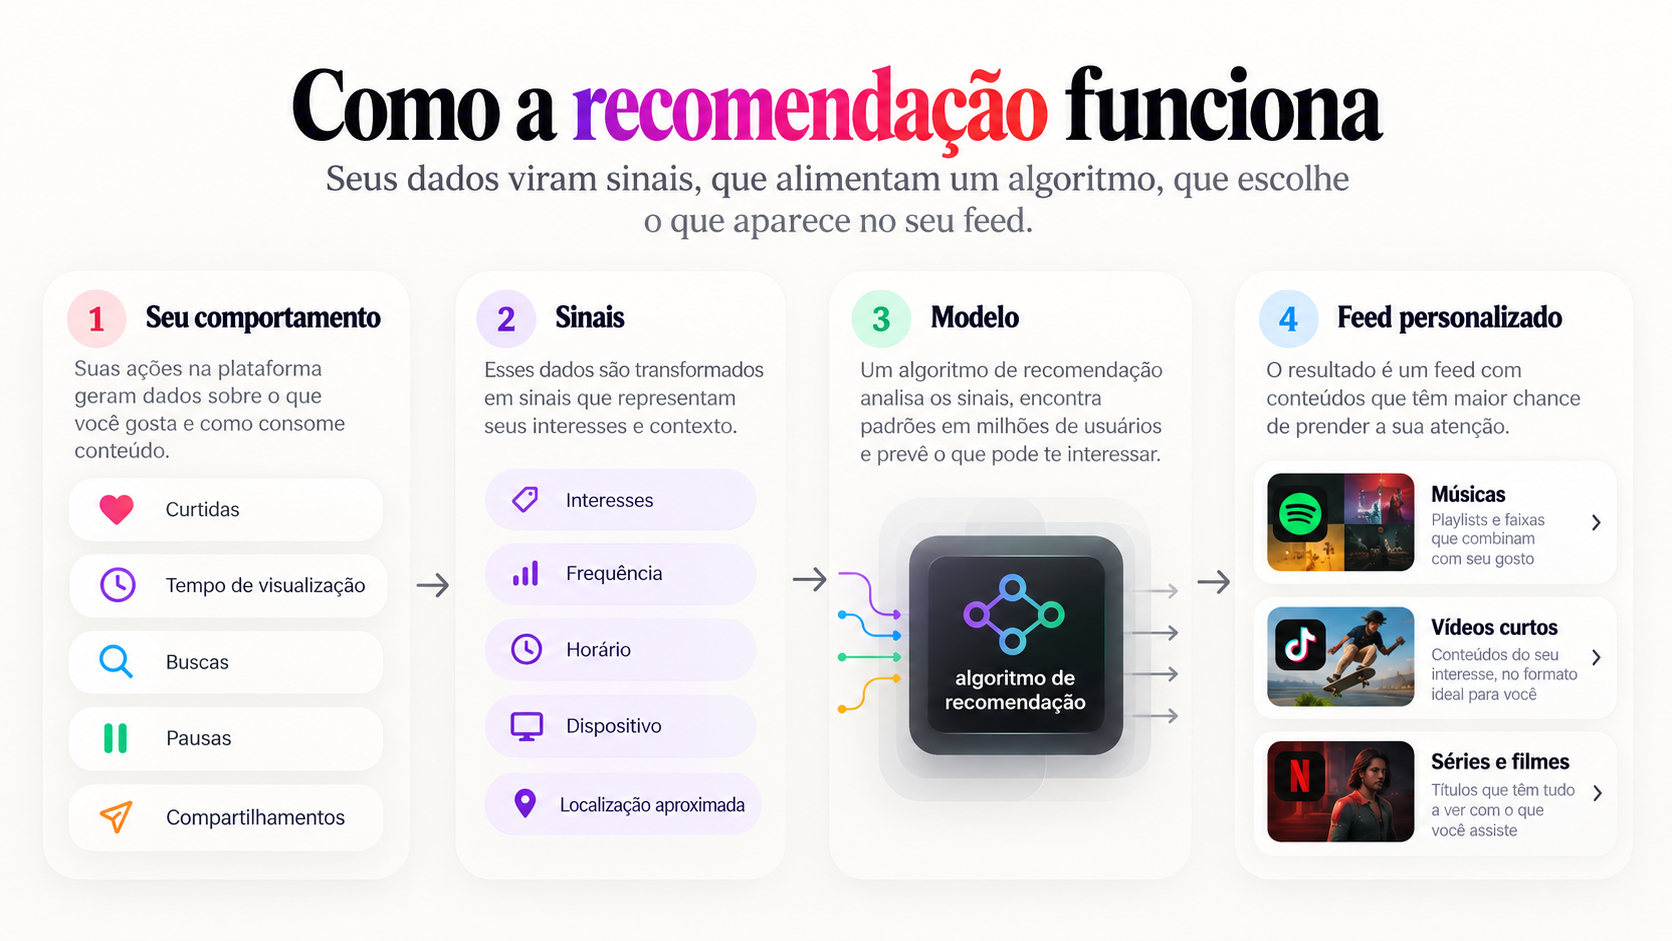
Elas observam uma enorme quantidade de sinais de comportamento, transformam esses sinais em dados e usam sistemas de recomendação para tentar responder a uma pergunta:
Qual conteúdo tem maior chance de interessar esta pessoa agora?
E essa palavra, agora, é importante.
O algoritmo não tenta apenas descobrir quem você é.
Ele também tenta descobrir:
- o que você costuma gostar;
- o que você está interessado neste momento;
- quanto tempo você dedica a determinados conteúdos;
- quais assuntos você ignora;
- quais padrões aparecem nas suas sessões;
- que tipo de conteúdo pessoas parecidas com você também consomem.
Neste artigo vamos sair um pouco da superfície e entender como isso funciona por trás do código.
Notas:
Sistemas de recomendação variam bastante entre plataformas e mudam constantemente. O objetivo deste artigo é explicar os princípios técnicos divulgados pelas próprias empresas e usados amplamente em sistemas modernos de recomendação — não reconstruir os algoritmos proprietários de cada serviço.
O que vamos entender
- Por que uma curtida é apenas um dos sinais possíveis.
- O que o tempo de visualização revela.
- Como o sistema transforma comportamento em números.
- Candidate generation e ranking.
- O que são embeddings.
- Collaborative filtering.
- Por que TikTok aprende tão rápido.
- Como Spotify personaliza músicas.
- Como Netflix organiza até a ordem das fileiras.
- Como Instagram decide o que mostrar.
- O papel de contexto, horário e dispositivo.
- Onde machine learning entra.
- Por que o algoritmo também erra.
- Como você consegue influenciar suas próprias recomendações.
Não existe um único “algoritmo”
Quando alguém diz:
“O algoritmo do Instagram me mostrou isso.”
parece que existe uma função gigante chamada:
algoritmoDoInstagram(usuario)
que decide tudo.
Na prática, plataformas desse tamanho possuem vários sistemas trabalhando juntos.
Podemos ter modelos diferentes para:
- Feed;
- Reels;
- Stories;
- pesquisa;
- anúncios;
- notificações;
- sugestões de contas;
- músicas;
- filmes;
- podcasts.
Uma visão simplificada seria:
O sistema observa sua reação ao resultado e usa essa nova informação em recomendações futuras.
Isso cria um ciclo.
A primeira matéria-prima é o seu comportamento
Toda interação pode virar um sinal.
No Instagram ou TikTok, por exemplo:
- você curtiu?
- compartilhou?
- comentou?
- salvou?
- seguiu a conta?
- assistiu até o final?
- voltou para assistir de novo?
- passou pelo vídeo imediatamente?
- pesquisou pelo assunto depois?
No Spotify:
- ouviu a música inteira?
- pulou nos primeiros segundos?
- adicionou à playlist?
- repetiu?
- procurou pelo artista?
- ouviu músicas parecidas?
Na Netflix:
- começou o filme?
- terminou?
- abandonou?
- deu like?
- assistiu vários títulos do mesmo gênero?
- voltou para uma segunda temporada?
A plataforma transforma comportamento em dados.

Nem todo sinal vale a mesma coisa
Imagine dois usuários.
O primeiro vê um vídeo por:
1 segundo
e passa.
O segundo:
assiste 40 segundos
↓
volta
↓
assiste novamente
↓
compartilha
Os dois tecnicamente “viram” o vídeo.
Mas os sinais são completamente diferentes.
O TikTok já explicou publicamente que sinais podem receber pesos diferentes. Assistir a um vídeo longo até o final, por exemplo, pode ser um indicador mais forte de interesse do que simplesmente ter uma configuração de país semelhante à do criador.
Podemos representar isso como uma pontuação extremamente simplificada:
const score =
  watchTime * 0.35 +
  completionRate * 0.25 +
  share * 0.20 +
  like * 0.10 +
  follow * 0.10;
Esse código não é o algoritmo real do TikTok.
É apenas uma maneira didática de entender a ideia:
sinais diferentes podem influenciar o ranking com intensidades diferentes.
O tempo talvez diga mais do que o like
Você pode curtir um vídeo apenas para apoiar um amigo.
Ou esquecer de curtir um vídeo que adorou.
Mas existe um comportamento mais difícil de fingir:
atenção
Quanto tempo você permanece em um conteúdo pode revelar muito.
Imagine:
É por isso que plataformas de vídeo levam watch time e conclusão muito a sério.
Seu comportamento vira uma representação matemática
Agora chegamos à parte mais interessante para quem gosta de código.
O sistema não precisa guardar algo literalmente assim:
{
  "marcos": {
    "gostaDe": [
      "tecnologia",
      "futebol",
      "design",
      "programacao"
    ]
  }
}
Sistemas modernos conseguem representar usuários e conteúdos como vetores.
Algo conceitualmente parecido com:
const userEmbedding = [
  0.82,
  0.11,
  -0.43,
  0.67,
  0.21,
  // ...
];
Esse vetor pode conter dezenas, centenas ou milhares de dimensões.
Você não olha para:
0.82
e diz:
“isso significa futebol.”
Não funciona assim.
As dimensões são aprendidas pelo modelo.
Embeddings: colocando gosto e conteúdo no mesmo espaço
Imagine um espaço matemático onde músicas parecidas ficam próximas.
Se o vetor de uma música estiver próximo do vetor que representa seus interesses, ela pode se tornar uma candidata forte.
Spotify divulgou que utiliza user embeddings em seus sistemas de personalização e, mais recentemente, vem explorando como transportar essas representações para sistemas de recomendação baseados em LLMs.
Isso ajuda a explicar como uma plataforma consegue condensar um histórico enorme de comportamento em uma representação que modelos conseguem processar rapidamente.
Mas primeiro é preciso encontrar candidatos
Netflix possui milhares de títulos.
Spotify possui um catálogo gigantesco.
TikTok e Instagram lidam com uma quantidade praticamente infinita de conteúdo novo.
Seria caro demais executar um modelo pesado para comparar:
você
contra:
todo conteúdo disponível
a cada abertura do aplicativo.
Por isso sistemas modernos frequentemente trabalham em etapas.
Spotify descreveu seu sistema de recomendação da Home de forma bastante clara:
Primeiro o sistema encontra algumas opções plausíveis.
Depois outro modelo organiza essas opções.
Candidate Generation
Imagine um catálogo com:
100 milhões de conteúdos
O sistema pode reduzir isso para:
10.000 candidatos
depois:
500
e finalmente:
50
que serão efetivamente considerados para determinada superfície.
Os números aqui são ilustrativos.
A ideia é o que importa.
Isso reduz drasticamente o custo computacional.
Ranking: quem chega primeiro?
Depois que temos candidatos, precisamos ordená-los.
Imagine:
const candidates = [
  "Video A",
  "Video B",
  "Video C",
  "Video D",
];
O modelo estima algo parecido com:
[
  { content: "Video C", score: 0.94 },
  { content: "Video A", score: 0.82 },
  { content: "Video D", score: 0.67 },
  { content: "Video B", score: 0.31 },
];
O conteúdo com maior probabilidade estimada de gerar uma boa experiência sobe.
Na vida real, porém, podem existir vários objetivos ao mesmo tempo.
Por exemplo:
- relevância;
- diversidade;
- novidade;
- segurança;
- qualidade;
- evitar repetição.
O ranking final não precisa ser simplesmente:
“o que gera mais clique fica em primeiro.”
Collaborative Filtering: pessoas parecidas também ajudam
Uma técnica clássica de recomendação é o:
Collaborative Filtering
A ideia é quase intuitiva.
Imagine:
Você gostou de A, B e C.
Outra pessoa gostou de A, B, C e D.
Talvez você também goste de D.
A Netflix declara que utiliza, entre outros fatores, informações de membros com gostos e preferências semelhantes.
Isso permite encontrar conteúdo que talvez você nunca pesquisasse diretamente.
Como a Netflix parece saber qual filme você quer assistir?
A Netflix explica que suas recomendações consideram sinais como:
- histórico de visualização;
- avaliações;
- pessoas com gosto semelhante;
- informações sobre os títulos;
- horário;
- idioma;
- dispositivo;
- duração do consumo.
Mas existe uma parte ainda mais interessante.
A personalização não está apenas em:
qual filme aparece
Ela também pode estar em:
qual fileira aparece
e:
qual posição o título ocupa
Por exemplo:
A própria Netflix explica que personaliza:
- a escolha das fileiras;
- os títulos de cada fileira;
- a ordem dos títulos.
Ou seja: a página inteira é um ranking.
Spotify: seu histórico musical vira contexto
Spotify talvez seja um dos exemplos mais fáceis de perceber.
Você escuta uma música.
Depois outra.
Começa a criar playlists.
Pula algumas faixas.
Repete outras.
O sistema começa a aprender relações.
Em outubro de 2026, Spotify revelou que está explorando uma arquitetura de recomendação generativa usando um Large Personalized Language Model.
A empresa descreve formas de incorporar preferências do usuário nesses modelos, inclusive usando embeddings existentes como entrada para o sistema.
Isso mostra como recomendação está indo além dos modelos tradicionais.
Instagram: várias previsões ao mesmo tempo
A Meta explica seus sistemas como modelos que fazem diversas previsões.
Por exemplo:
qual a chance de você compartilhar?
qual a chance de comentar?
qual a chance de curtir?
qual a chance de achar relevante?
Essas previsões podem ser combinadas.
Isso ajuda a entender por que duas pessoas seguindo exatamente as mesmas contas podem receber feeds muito diferentes.
Em 2026, até suas interações com IA podem virar sinal
A Meta anunciou uma mudança interessante.
Desde dezembro de 2025, interações com recursos de Meta AI podem ser utilizadas como mais um sinal de personalização de conteúdo e anúncios em suas plataformas, conforme a política e os controles disponíveis.
Isso mostra como a quantidade de contexto usada por sistemas de recomendação continua aumentando.
Antes:
curtidas
+
comentários
+
visualizações
Agora também pode existir:
interação com assistentes
dependendo do produto e da configuração.
TikTok: feedback acontece em segundos
TikTok possui uma característica muito importante:
vídeos curtos
Isso significa que o sistema recebe feedback muito rapidamente.
Você pode assistir:
20 vídeos
em poucos minutos.
Cada vídeo gera sinais.
Então em uma sessão curta o sistema já recebeu várias oportunidades de atualizar sua percepção dos seus interesses.
Isso ajuda a explicar por que o feed Para Você parece aprender tão rápido.
O contexto também importa
Você não é exatamente a mesma pessoa o dia inteiro.
Às:
07:00
pode ouvir uma coisa.
Às:
23:30
outra.
Plataformas podem considerar diferentes aspectos de contexto.
A Netflix, por exemplo, declara considerar horário, idioma e dispositivo entre os sinais utilizados.
Isso permite algo semelhante a:
const context = {
  time: "23:30",
  device: "tv",
  language: "pt-BR",
  recentActivity: ["suspense", "crime"],
};
Novamente: é um exemplo didático.
Mas representa a ideia de que recomendação não depende apenas de um perfil estático.
O algoritmo não precisa “saber quem você é”
Esse ponto é importante.
Para recomendar conteúdo, o sistema não precisa necessariamente entender sua personalidade como uma pessoa entenderia.
Ele precisa encontrar padrões suficientes para prever comportamento.

Podemos imaginar algo assim:
Para o computador, você pode ser representado temporariamente por:
vetores
+
eventos
+
histórico
+
contexto
E isso já é suficiente para gerar recomendações assustadoramente boas.
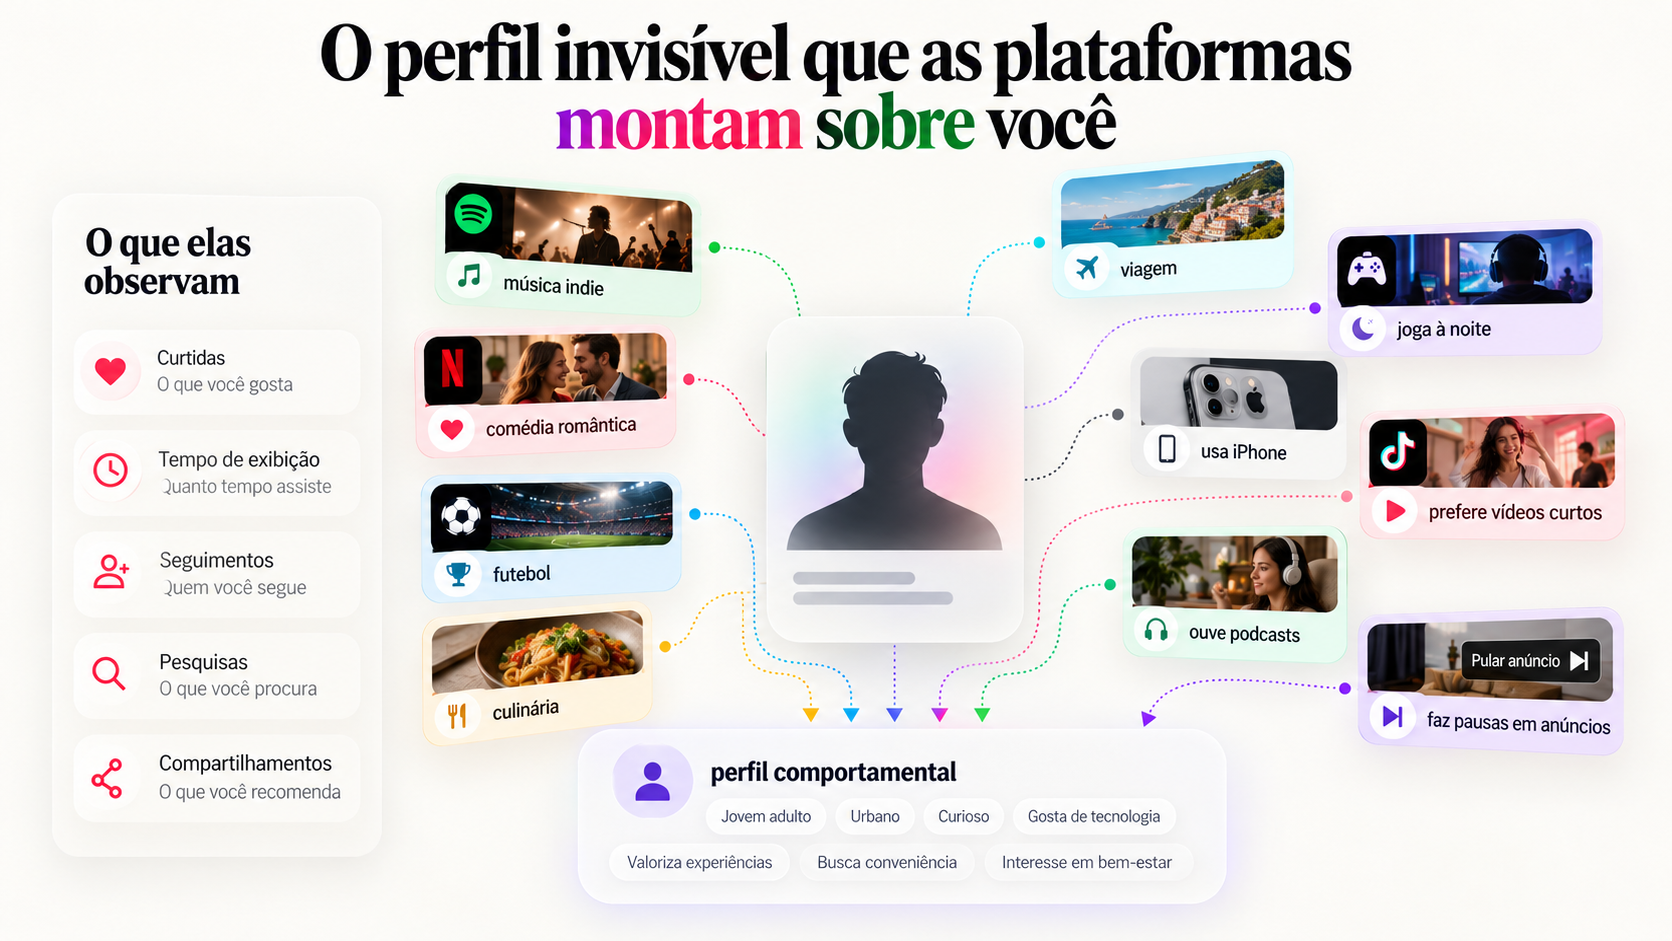
O “perfil invisível” não precisa ser uma ficha literal
Quando falamos que plataformas “montam um perfil”, é fácil imaginar:
Nome: João
Idade: 27
Gosta de futebol
Ouve rock
Assiste terror
Sistemas modernos podem funcionar de maneira muito mais abstrata.
Podem existir:
- embeddings;
- probabilidades;
- segmentos;
- histórico;
- features derivadas.

Isso é importante porque o sistema pode descobrir relações que você nunca declarou explicitamente.
Por exemplo: você nunca disse que gosta de culinária
Mas imagine que você:
assiste receitas até o final
↓
salva vídeos de massas
↓
segue dois chefs
↓
pesquisa restaurante italiano
Nenhum formulário perguntou:
“Você gosta de culinária?”
Mesmo assim, existe evidência suficiente para o sistema testar mais conteúdo desse tipo.
Se você responde positivamente, o sinal fica mais forte.
Exploration vs Exploitation
Existe outro problema interessante em sistemas de recomendação.
Se a plataforma sempre mostrar apenas aquilo que já sabe que você gosta:
você nunca descobre nada novo
Mas se mostrar apenas coisas novas:
a recomendação fica ruim
Esse equilíbrio é conhecido como:
exploration
vs
exploitation
Sistemas precisam explorar ocasionalmente para descobrir novos interesses.
É por isso que aparece algo completamente diferente
Às vezes o feed mostra um assunto que parece aleatório.
Pode ser:
- conteúdo popular;
- exploração;
- diversidade;
- teste de interesse;
- recomendação baseada em usuários semelhantes.
Se você ignora:
sinal
Se você para e assiste:
outro sinal
O sistema aprende de qualquer forma.
E onde entra o machine learning?
Em uma aplicação tradicional podemos escrever regras:
if (user.likes.includes("rock")) {
  recommend("rock");
}
Mas plataformas gigantes lidam com relações muito mais complexas.
milhões de usuários
+
milhões de conteúdos
+
bilhões de interações
É aí que machine learning se torna útil.
O modelo aprende padrões diretamente dos dados.
Um exemplo simplificado
Imagine que queremos prever:
probabilidade de assistir um vídeo até o final
Features:
const features = {
  userVideoSimilarity: 0.82,
  creatorAffinity: 0.63,
  topicInterest: 0.91,
  videoDuration: 28,
  hour: 22,
};
O modelo retorna:
const completionProbability = 0.87;
Outro vídeo pode ter:
0.32;
A plataforma pode usar essas probabilidades para ajudar no ranking.
E isso acontece para cada pessoa
A escala é a parte impressionante.
Imagine:
1 vídeo
×
milhões de usuários
×
milhares de candidatos
Por isso empresas investem tanto em:
- GPUs;
- feature stores;
- sistemas distribuídos;
- bancos de dados;
- pipelines de streaming;
- inferência de baixa latência.
O problema não é apenas criar um modelo.
É executar tudo rápido o suficiente para que você abra o aplicativo e o feed apareça praticamente instantaneamente.
O algoritmo também erra
Apesar da sensação de precisão, sistemas de recomendação erram bastante.
Talvez você tenha pesquisado:
berço
porque queria comprar um presente.
Depois:
seu feed inteiro vira conteúdo de bebê
Para o algoritmo existe um sinal.
Mas falta contexto humano.
O sistema não sabe necessariamente:
por que você pesquisou
Ele observa correlação.
Feedback loops podem prender o sistema
Imagine:
Isso pode criar um:
feedback loop
E é um dos motivos pelos quais diversidade e mecanismos de controle são importantes.
Você consegue treinar seu próprio algoritmo?
Até certo ponto, sim.
As plataformas oferecem diferentes controles.
Você pode:
- marcar “não tenho interesse”;
- deixar de seguir contas;
- avaliar filmes;
- remover conteúdos do histórico;
- pular músicas;
- pesquisar novos assuntos;
- limpar ou ajustar determinados dados.
Esses comportamentos geram novos sinais.
TikTok, por exemplo, oferece a opção de explicar por que determinado vídeo foi recomendado e controles para ajustar a experiência.
Netflix permite usar avaliações como:
Não é para mim
Gostei
Amei
Esses sinais ajudam o sistema.
Não existe mágica. Existe estatística em escala.
Talvez essa seja a melhor forma de resumir.
Quando uma plataforma parece saber exatamente aquilo que você queria assistir, não significa necessariamente que ela:
leu sua mente
Ela possui:
muitos sinais
+
muitos usuários
+
muito conteúdo
+
modelos muito bons
e consegue fazer previsões cada vez melhores.
Seu microfone está ouvindo tudo para recomendar anúncios?
Esse é um mito comum.
A sensação surge porque as recomendações podem ser assustadoramente específicas.
Mas existe uma explicação muito menos cinematográfica:
seu comportamento digital já produz muitos sinais
Uma plataforma pode saber que você:
- pesquisou determinado tema;
- visitou uma página;
- assistiu conteúdos relacionados;
- interagiu com pessoas interessadas naquele assunto;
- costuma consumir determinado tipo de conteúdo.
Não é necessário inventar uma explicação baseada em gravação constante do microfone para explicar boa parte dessas coincidências.
Notas:
Isso não significa que questões de privacidade deixem de existir. Coleta de dados, rastreamento, publicidade comportamental e compartilhamento de informações são assuntos reais e merecem análise própria. O ponto é apenas que sistemas de recomendação conseguem inferir muito a partir de comportamento comum.
O lado bom da personalização
Quando funciona bem:
menos busca
↓
mais descoberta
↓
conteúdo relevante
Spotify pode apresentar um artista que você nunca encontraria.
Netflix pode destacar um filme desconhecido.
TikTok pode conectar você a um tema extremamente específico.
Instagram pode mostrar criadores pequenos alinhados aos seus interesses.
Isso é uma conquista tecnológica real.
O lado problemático
O mesmo sistema que aumenta relevância também compete por:
atenção
E isso cria questões importantes.
Por exemplo:
- quanto tempo queremos passar no aplicativo?
- quem decide o que aparece?
- quais comportamentos o sistema otimiza?
- personalização pode limitar diversidade?
- como evitar conteúdos nocivos?
- quais dados deveriam ser utilizados?
Essas perguntas já não são apenas de engenharia.
São questões de produto, UX, negócio, ética e regulação.
Para desenvolvedores: recomendação é muito mais do que if
O que parece simples na interface exige uma infraestrutura enorme.
Essa arquitetura conecta áreas como:
- Front-end;
- Back-end;
- Data Engineering;
- Machine Learning;
- DevOps;
- UX;
- Product Design.
É um ótimo exemplo de como uma funcionalidade aparentemente simples pode envolver praticamente toda a engenharia de uma empresa.
✅ Resultado Final
Instagram, Spotify, Netflix e TikTok parecem conhecer você tão bem porque transformam comportamento em sinais e sinais em previsões.
O processo pode ser resumido assim:
- Você interage com a plataforma.
- Essas interações viram eventos e sinais.
- O sistema cria features e representações.
- Modelos selecionam candidatos.
- Outros modelos fazem ranking.
- A plataforma mostra o conteúdo.
- Sua reação gera novos sinais.
- O ciclo recomeça.
🛠️ Considerações Finais
Talvez a parte mais interessante dos algoritmos de recomendação seja perceber que eles não precisam realmente “conhecer você” da mesma maneira que outra pessoa conhece.
Eles precisam apenas prever seu próximo comportamento com uma precisão suficiente.
Para isso, utilizam:
histórico
+
contexto
+
interações
+
similaridades
+
machine learning
Uma curtida sozinha diz pouco.
Mas milhares de pequenas decisões acumuladas criam um padrão.
E quando esse padrão é comparado com milhões de outros usuários e conteúdos, a plataforma consegue fazer previsões extremamente boas.
É por isso que às vezes você abre o Spotify e pensa:
“Era exatamente essa música que eu queria ouvir.”
Ou entra no TikTok apenas por cinco minutos e percebe meia hora depois que continua assistindo.
Não é magia.
É engenharia, estatística, machine learning e uma quantidade enorme de dados trabalhando em conjunto.
E talvez a pergunta mais importante não seja apenas:
“Como eles sabem do que eu gosto?”
Mas também:
“Quanto do que eu gosto foi descoberto pelo algoritmo — e quanto foi reforçado por aquilo que ele decidiu me mostrar?”
Essa segunda pergunta talvez seja ainda mais interessante.
Referências
- Meta — Como a inteligência artificial influencia o que você vê no Facebook e no Instagram
- Meta — Improving Your Recommendations on Our Apps With AI
- Spotify Engineering — Why We Use Separate Tech Stacks for Personalization and Experimentation
- Spotify Engineering — Advancing Generative Recommendation Inference
- Spotify Engineering — Personalizing Content on Home
- Netflix — How Netflix’s Recommendations System Works
- TikTok — Como o TikTok recomenda vídeos para o feed Para Você
- TikTok — Entenda por que um vídeo é recomendado para você